Rime, dos EUA, constrói sistema próprio de dados de voz e impulsiona a implementação de modelos de voz para voz com baixa latência
De acordo com pt.wedoany.com-A empresa americana de inteligência artificial de voz Rime está expandindo seu sistema de coleta de dados de voz, desenvolvimento de modelos e entrega setorial, com foco no avanço de modelos de voz para voz de baixa latência. A empresa construiu seu próprio estúdio de gravação em São Francisco, nos EUA, coletando dados de treinamento por meio de gravações de conversas reais entre pessoas, reduzindo a dependência de áudio público da internet e otimizando a capacidade de interação por voz em cenários como atendimento ao cliente empresarial, serviços médicos, operações aéreas e tecnologia financeira.
A Rime, dos EUA, foi fundada em 2022, e os membros da equipe fundadora têm experiência em pesquisa na Universidade de Stanford, desenvolvimento do sistema de voz Alexa da Amazon e engenharia de pesquisa. Diferente do método de extrair diretamente áudio da internet para treinar modelos, a empresa coleta dados de conversas com informações claras de falante, contexto e pronúncia em estúdios de gravação, utilizando esses dados para treinamento de síntese de voz, controle de pronúncia e modelos de interação.
O sistema próprio de gravação permite que o treinamento do modelo seja mais direcionado. Sistemas de voz empresariais frequentemente precisam lidar com nomes de marcas, modelos de produtos, nomes de medicamentos e termos técnicos específicos do setor em uso real, e modelos de voz genéricos são propensos a erros de acentuação, omissão de sílabas ou pronúncia inconsistente. A Rime, dos EUA, adota uma arquitetura de modelo baseada em fonemas, decompondo palavras em unidades de pronúncia mais básicas e ajustando a forma de pronúncia de acordo com o ambiente de uso de diferentes empresas e setores.
Essa abordagem técnica não exige que os clientes retreinem o modelo completo. As empresas podem adicionar vocabulário de marca, termos técnicos e pronúncias específicas ao sistema de voz existente, permitindo que a voz de IA mantenha alta precisão ao lidar com conteúdos especializados em áreas como medicina, aviação e finanças. O foco da pesquisa já se deslocou da simples geração de sons naturais para resolver a consistência de pronúncia e a estabilidade da interação por voz em operações reais.
Anteriormente, a Rime, dos EUA, utilizava um pipeline de múltiplos modelos composto por conversão de voz em texto, processamento de texto, modelo de linguagem grande e conversão de texto em voz. Quando o usuário falava, o sistema precisava primeiro reconhecer o texto, depois gerar uma resposta com o modelo de linguagem grande e, finalmente, converter o texto em voz. A execução sequencial de vários modelos tende a aumentar o tempo de espera e pode resultar em tom, pausas e transições de turno não naturais.
A empresa está atualmente migrando para o desenvolvimento de modelos de voz para voz, permitindo que o sistema compreenda diretamente a entrada de voz e gere saída de voz, reduzindo as etapas de orquestração entre vários modelos. A nova direção de pesquisa foca em resolver problemas como latência de resposta, alternância de turnos em conversas com múltiplas pessoas, interferência de ruído de fundo e interrupções do usuário, aproximando o agente de voz de IA do ritmo de comunicação de um atendente humano real.
Modelos de voz para voz também precisam integrar compreensão semântica, geração de voz e interação em tempo real em um sistema unificado. O modelo não só precisa determinar o que o usuário disse, mas também identificar a velocidade da fala, a posição das pausas e se a conversa terminou, para então decidir quando responder. Com a redução do número de modelos intermediários, o caminho de execução do sistema é mais curto, facilitando também o controle unificado do estilo de voz, emoção e pronúncia.
Os modelos de voz da Rime, dos EUA, já são aplicados em setores como serviços de alimentação, saúde, aviação e tecnologia financeira, com clientes incluindo a Mayo Clinic, Dialpad, Upstart e Asurion, todos dos EUA. Diferentes aplicações têm requisitos distintos para o sistema de voz: cenários médicos exigem processamento preciso de nomes de doenças e medicamentos, cenários de aviação precisam identificar informações de voos e aeroportos, enquanto sistemas de atendimento ao cliente focam mais na velocidade de resposta e na estabilidade durante chamadas longas.
A empresa também planeja expandir as equipes de desenvolvimento de modelos, implementação de engenharia e entrega de parcerias, fortalecendo a capacidade dos modelos de voz de transitar do ambiente de pesquisa para sistemas empresariais. A Rime, dos EUA, recentemente contratou um cientista-chefe com experiência em compreensão de áudio e pesquisa em aprendizado profundo, e continuará aprimorando os processos de coleta de dados, treinamento de modelos, implantação de sistemas e adaptação ao cliente.
O cerne deste ajuste de negócios não é simplesmente aumentar o número de modelos de voz, mas construir um sistema completo que vai desde a coleta de voz humana, processamento de dados fonêmicos, desenvolvimento de modelos até a entrega empresarial. Os próximos avanços serão refletidos principalmente na implementação de modelos de voz para voz, redução da latência de interação, capacidade de reconhecimento em ambientes ruidosos e integração com mais sistemas setoriais.
Produtos Relacionados

TWP16 Radar de Perfil de Vento Troposférico na Banda P
China Huayun Meteorological Technology Group Co., Ltd.
Fibra monomodo não-dispersiva deslocada com extensão de faixa de comprimento de onda G.652.D
HONGAN GROUP CO. LTD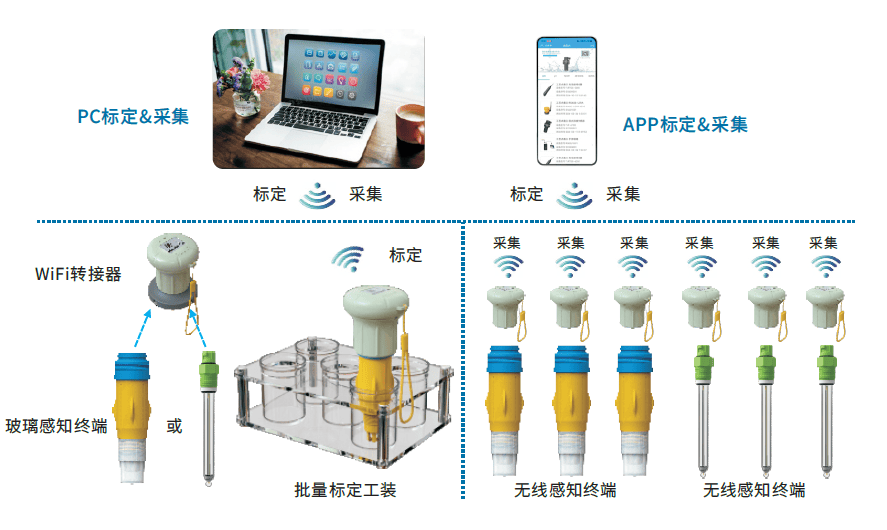

Software do Sistema de Verificação / Calibração de Pressão ACal
Beijing ConST Instruments Technology Inc.
Terminal satelital portátil de placa Terminal portátil manual com abertura de 0,35 metros
China Starwin Science & Technology co., Ltd.
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION
Sistema de Gestão do Ciclo de Vida de Equipamentos
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.
Radar de Monitoramento Oceânico Multifuncional para Baixa Altura – Medição de Ambiente Dinâmico Marítimo e Atmosférico
Chengdu Dixin Technology Co., Ltd.
Cabo Óptico GYTA do tipo Não Auto-Suportado para Aéreo e Dutos
TONGDING INTERCONNECTION INFORMATION CO., LTD.