Solução RDMA direta entre GPU da Kiwi Technology e Biren Technology reduz latência pela metade e aumenta drasticamente a taxa de transferência
De acordo com pt.wedoany.com-A Kiwi Technology e a Biren Technology apresentam solução direta para GPUs chinesas na Conferência Mundial de Inteligência Artificial
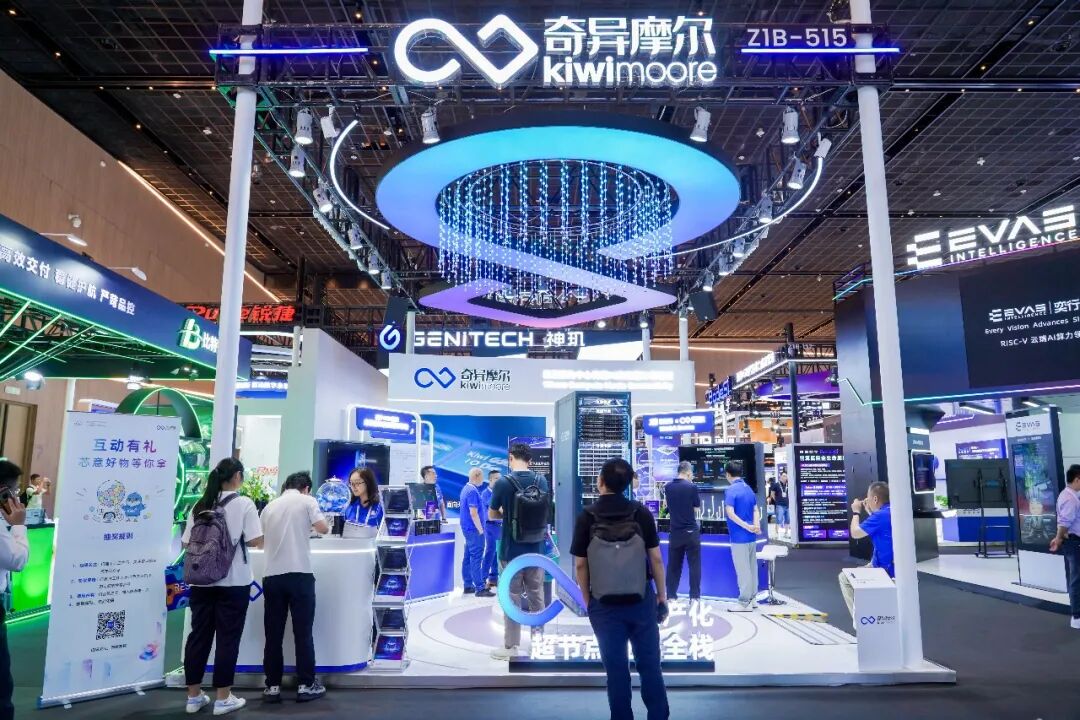
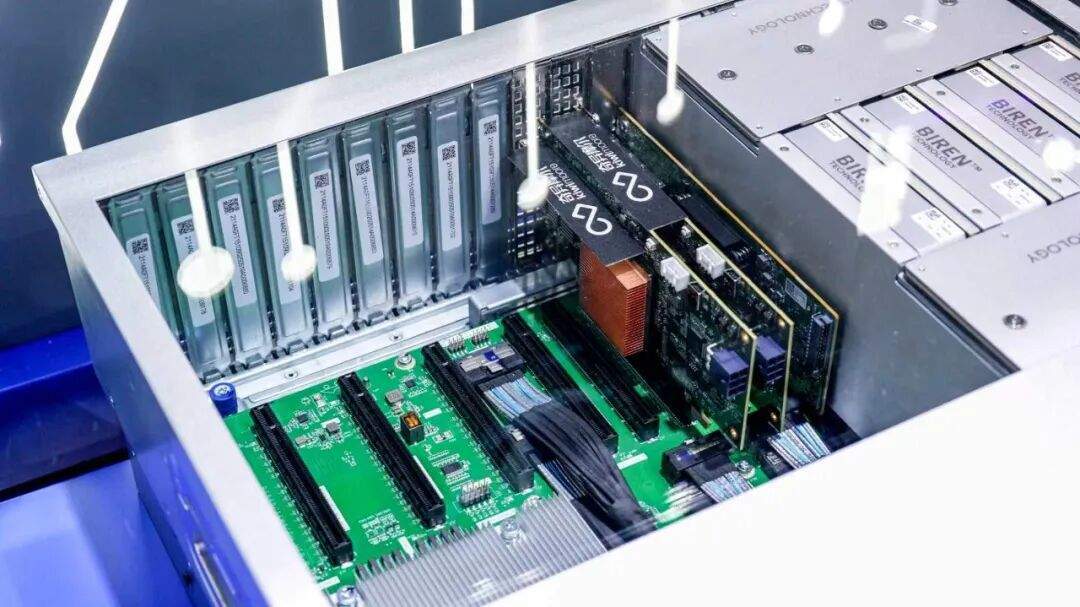
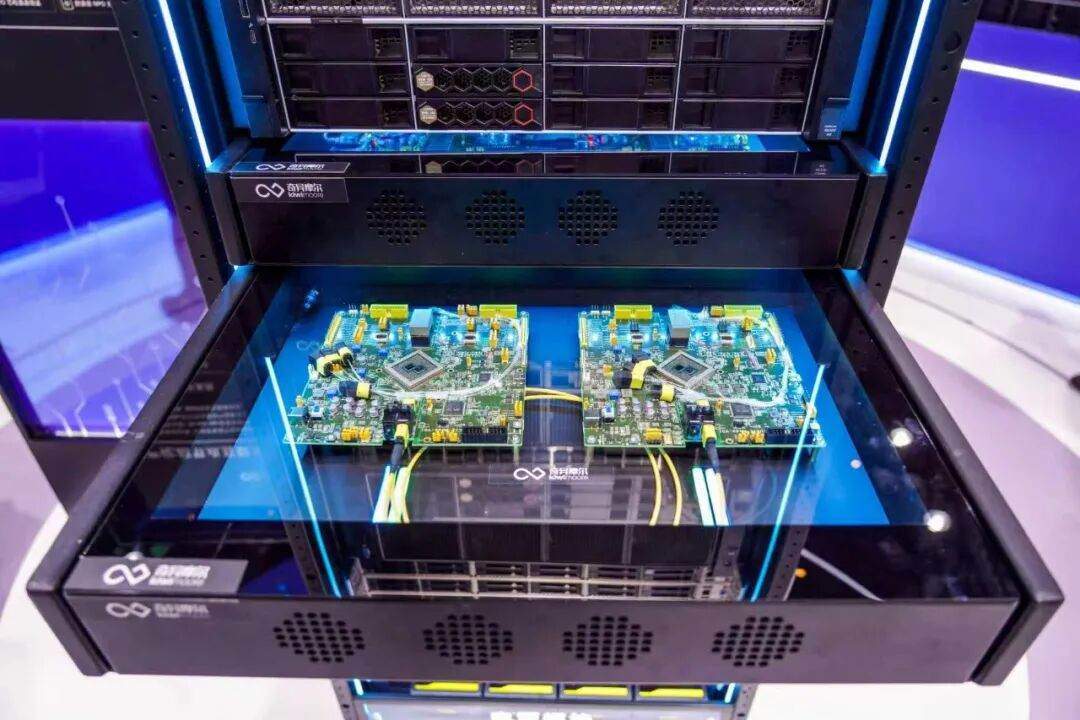
Na Conferência Mundial de Inteligência Artificial (WAIC 2026), realizada em Xangai de 17 a 20 de julho de 2026, a Kiwi Technology, empresa de tecnologia de interconexão de redes de IA, e a Biren Technology, fabricante chinesa de GPUs, demonstraram conjuntamente a solução de comunicação IBGDA para "GPU nacional conectada diretamente a placa de rede RDMA nacional". Dados de testes reais mostram que, em cenários de pacotes pequenos e alta frequência, a taxa de transferência de comunicação All-to-All aumentou significativamente, com a latência reduzida quase pela metade. Este resultado marca um avanço crucial na coordenação em nível de sistema para clusters de computação de IA nacionais.
A Kiwi Technology é uma empresa de tecnologia focada em produtos e soluções de interconexão de ponta a ponta para redes de IA, abrangendo desde interconexão de rede Scale-Out, interconexão entre XPUs de supernós Scale-Up até soluções de ponta a ponta para interconexão óptica de próxima geração. A Biren Technology é uma empresa chinesa de design de chips GPU de alto desempenho e uso geral, dedicada a fornecer uma base de computação autônoma e controlável para computação de IA. Por muito tempo, para que GPUs nacionais alcançassem comunicação eficiente em cluster, era necessário depender de placas de rede da NVIDIA, o que se tornou um gargalo importante para a autonomia dos clusters de computação nacionais. A solução IBGDA demonstrada conjuntamente por ambas as empresas, utilizando o mecanismo ASIC RDMA de 400G de canal único desenvolvido pela Kiwi Technology (baseado na arquitetura da plataforma Kiwi SNIC 800G), alcançou uma colaboração profunda entre GPUs nacionais e placas de rede RDMA nacionais.
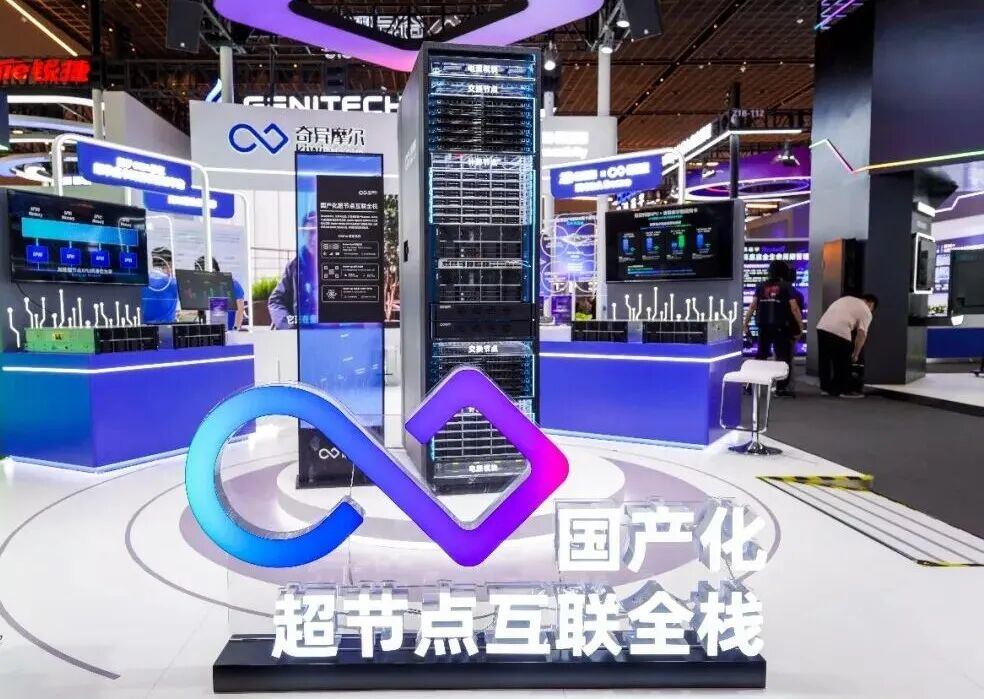
Em cenários típicos de treinamento e inferência de modelos MoE (Especialistas Mistos), a comunicação paralela de especialistas inclui duas fases principais: Dispatch e Combine, cada uma envolvendo uma enorme quantidade de troca de dados em pequena granularidade. Os métodos tradicionais de comunicação entre nós exigem que a GPU passe instruções através da CPU, gerando latência adicional e sobrecarga da CPU. A tecnologia IBGDA, ao contornar o processamento da CPU, reduz significativamente o tempo de espera para transferência de instruções, liberando totalmente a vantagem de taxa de transferência da GPU em computação paralela. Dados de testes reais mostram que o IBGDA apresenta vantagens geracionais em cenários de pacotes pequenos, alta frequência e forte sincronização em comparação com soluções tradicionais: a largura de banda de mensagens pequenas individuais aumenta drasticamente, a taxa de transferência de envio de pacotes pequenos originais e de envio combinado alcança um salto qualitativo, e a "penalidade de pacotes pequenos" das soluções tradicionais, onde o tempo de mensagens pequenas é muito maior que o de mensagens grandes, é completamente eliminada. Esta solução é construída com base no ecossistema Ethernet aberto, herdando as vantagens de flexibilidade de implantação e custo controlável da Ethernet, ao mesmo tempo que oferece uma opção de rede de alto desempenho e autonomia para clusters de computação nacionais.
Nesta conferência, a Kiwi Technology também se uniu à Shanghai Computing Power Network Association, ao Shanghai Artificial Intelligence Laboratory, ao East China Branch do China Academy of Information and Communications Technology, bem como a empresas da cadeia industrial como Biren Technology, Muxi, Tianshu Zhixin, Enflame Technology, SenseTime e Sugon Information, para lançar conjuntamente a "Iniciativa de Ação para a Construção Conjunta do Ecossistema de Supernós Nacionais". Além disso, a Kiwi Technology, em parceria com a Universidade de Ciência e Tecnologia de Hong Kong (Guangzhou), a XiWang Technology, a Biren Technology, a Turing Quantum e a Singularity Photonics, publicou conjuntamente o "Livro Branco da Tecnologia de Fotônica Empacotada (CPO)", fornecendo orientação para a padronização e desenvolvimento industrial da tecnologia de interconexão óptica nacional.
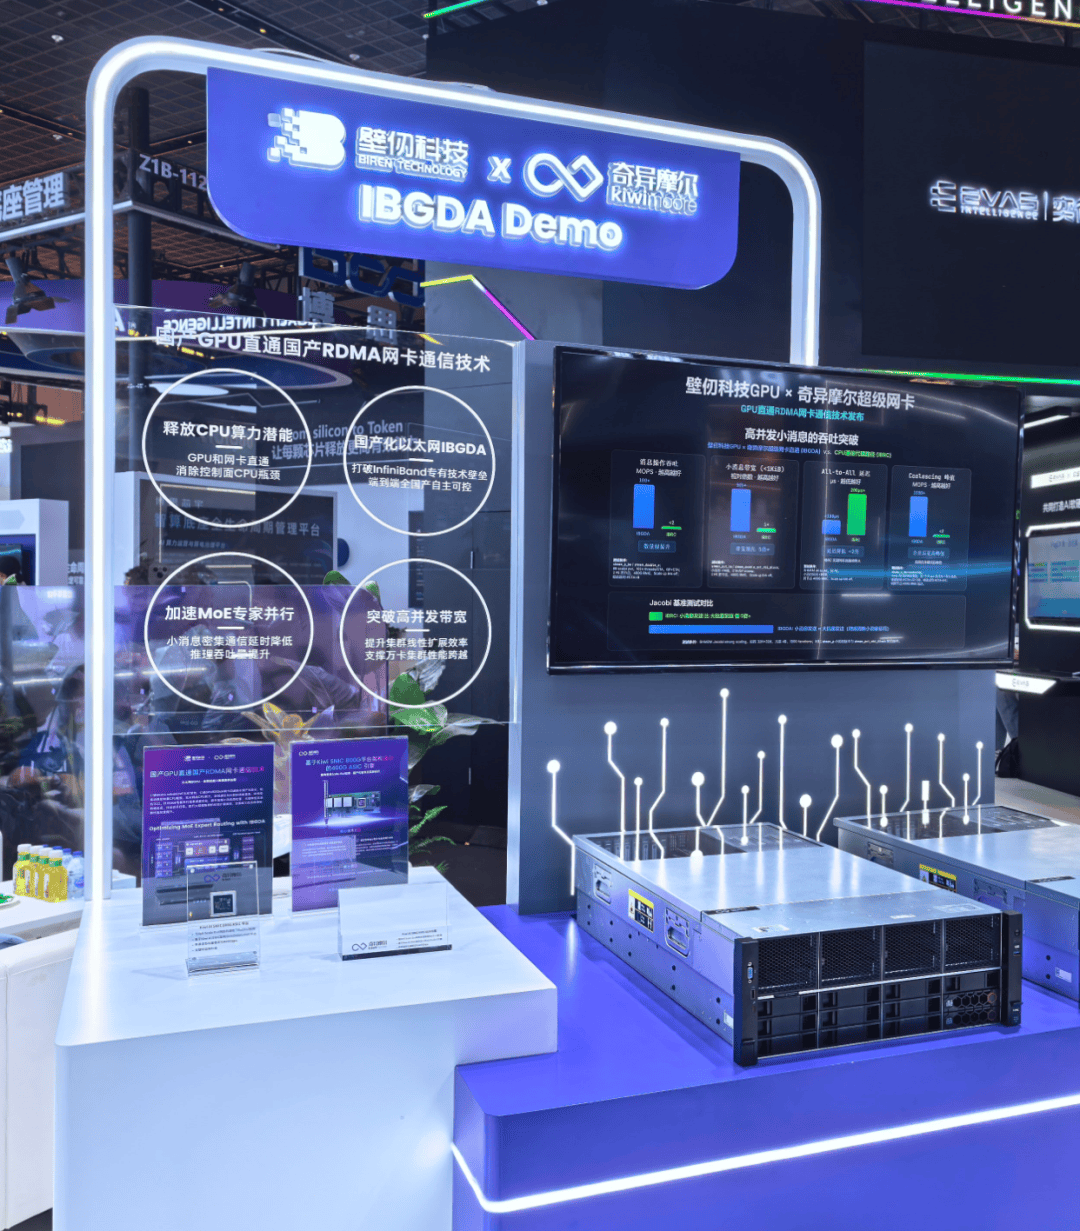
A verificação prática desta solução direta para GPU nacional prova, pela primeira vez com dados, que o caminho tecnológico de "chip nacional + rede nacional" já possui capacidade prática de otimização colaborativa em nível de sistema. Este avanço ajuda a impulsionar a computação de IA nacional de um "avanço de chip individual" para uma "otimização colaborativa em nível de sistema", alcançando um desenvolvimento transformador.
Produtos Relacionados

Serviço completo de gestão integrada para toda a cadeia do sistema logístico
Zhongding Intelligent (Wuxi) Technology Co., Ltd.
Radar Meteorológico de Banda C Série 714CD
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.
±1100kV Torre de Aço Angular para Corrente Contínua de Ultralta Tensão
Henan Dingli Pole & Tower Co., Ltd.
QPS- 20A Comutador Rápido de Fonte de Alimentação Redundante
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.
Sistema de informação inteligente
LUOYANG SHANHAI MACHINERY MANUFACTURING CO., LTD.