Modelo DeepSeek V4.1 Flash é oficialmente lançado: supera totalmente o V4 Pro, compreensão visual multimodal nativa, preços da API reduzidos
De acordo com pt.wedoany.com-Em 10 de setembro, a DeepSeek lançou oficialmente o modelo DeepSeek V4.1 Flash. Este é o modelo de menor dimensão da sua nova série de arquiteturas de modelos, com capacidade de compreensão visual multimodal nativa.
O design da nova arquitetura de modelo tem como objetivo: limite de capacidade superior, velocidade de inferência mais rápida, maior throughput e escalabilidade para modelos com maior número de parâmetros.
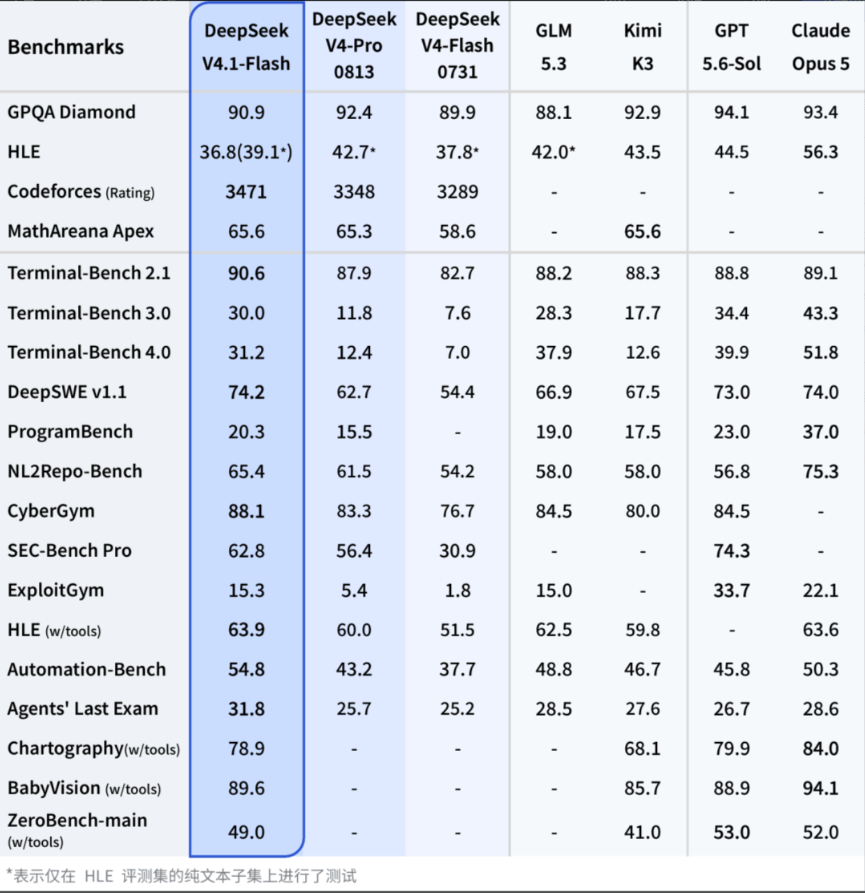
O DeepSeek V4.1 Flash é um modelo MoE com 552B de parâmetros, adotando uma nova estrutura Causal-Encoder-Decoder, com entrada e saída assimétricas, ativação de entrada de apenas 8B e ativação de saída de 16B, com custo significativamente inferior ao de modelos conhecidos de dimensão semelhante. Ao mesmo tempo, o V4.1 Flash também adota um novo método de pré-treinamento e passou por pós-treinamento com aprendizado por reforço em maior escala, superando com sucesso, em testes de referência, o nível de inteligência de diversos modelos de ponta, incluindo o DeepSeek V4 Pro.
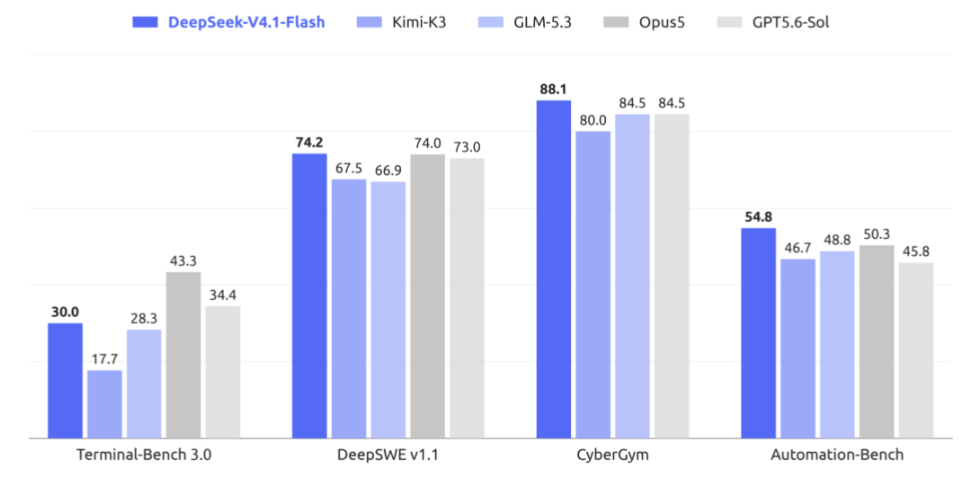
Comparação de desempenho entre o DeepSeek-V4.1-Flash e modelos de ponta mainstream no Agentic Benchmark
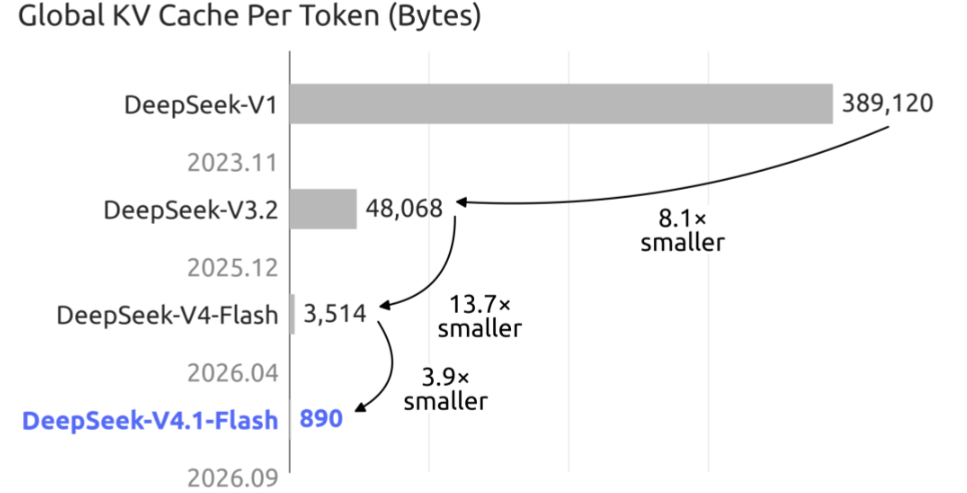
Além disso, a nova geração de modelos reduziu significativamente o tamanho do KV Cache; em comparação com a geração anterior, a necessidade de HBM foi reduzida para 1/4 e a necessidade de SSD foi reduzida para 1/8.
Em cenários de uso de Agent, o custo de acerto de cache costuma representar uma proporção elevada, e a compressão do KV Cache reduziu drasticamente o custo de uso de tarefas do tipo Agent.
Como mostrado na figura, o DeepSeek apresenta progresso contínuo na redução do armazenamento de contexto. Em relação ao modelo de primeira geração, o KV Cache é 1/437 do original.
O DeepSeek V4.1 Flash já está disponível na DeepSeek API, com suporte nativo a multimodalidade; basta alterar o nome do modelo para deepseek-flash para chamar o mais recente modelo V4.1 Flash.
Os modelos de versões antigas V4 Flash e V4 Flash Vision Exp foram descontinuados; por considerações de compatibilidade, os nomes de modelo deepseek-v4-flash e deepseek-v4-flash-vision-exp serão temporariamente roteados para o V4.1 Flash.
Ao mesmo tempo, após testes por diversas partes, o V4.1 Flash já superou totalmente o V4 Pro em todos os indicadores, incluindo desempenho, custo, velocidade e tempo total, portanto a empresa planeja descontinuar ordenadamente o modelo V4 Pro. Após as 12:00 (horário de Pequim) de 14 de setembro de 2026, até o lançamento futuro do V4.1 Pro, as solicitações dos usuários para deepseek-v4-pro serão todas roteadas para o V4.1 Flash e cobradas de acordo com o preço unitário do V4.1 Flash.
A Tencent (WorkBuddy, CodeBuddy) e a OpenCode, como parceiros oficiais, já integraram totalmente o DeepSeek V4.1 Flash.
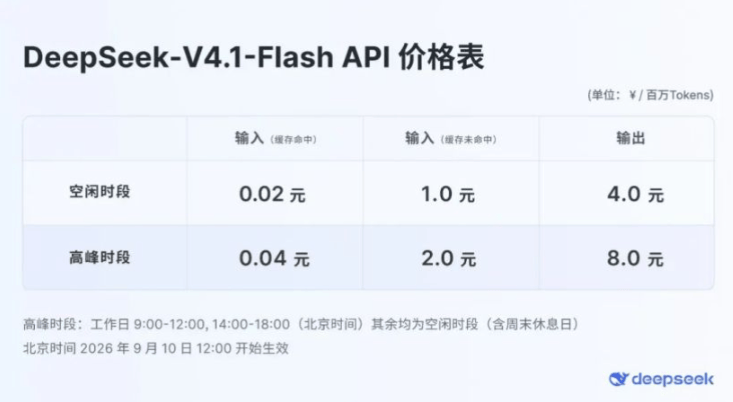
Graças à inovação na arquitetura do modelo, o DeepSeek V4.1 Flash pode atender mais usuários com custo menor, portanto a empresa reduziu correspondentemente o preço do V4.1 Flash.
Ao mesmo tempo, para alocar recursos de forma mais racional, o DeepSeek V4.1 Flash ainda adota preços de pico e fora de pico, com o preço em horário ocioso sendo metade do preço em horário de pico, incentivando os usuários a ajustar o horário das tarefas de acordo com o uso real. Os novos preços entram em vigor a partir das 12:00 de 10 de setembro de 2026.
Produtos Relacionados

±1100kV Torre de Aço Angular para Corrente Contínua de Ultralta Tensão
Henan Dingli Pole & Tower Co., Ltd.
Solução de Prevenção contra Vazamento de Dados para Escritórios
Sangfor Technologies Inc.
Sistema de Gestão do Ciclo de Vida de Equipamentos
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.
Serviço completo de gestão integrada para toda a cadeia do sistema logístico
Zhongding Intelligent (Wuxi) Technology Co., Ltd.
Robô humanoide D12
Automation Research Institute Co., Ltd. of China South Industries Group Corporation
QPS- 20A Comutador Rápido de Fonte de Alimentação Redundante
CHN ENERGY ZHISHEN CONTROL TECHNOLOGY CO., LTD.
Cabo Óptico GYTA do tipo Não Auto-Suportado para Aéreo e Dutos
TONGDING INTERCONNECTION INFORMATION CO., LTD.

Radar de Monitoramento Oceânico Multifuncional para Baixa Altura – Medição de Ambiente Dinâmico Marítimo e Atmosférico
Chengdu Dixin Technology Co., Ltd.