NVIDIA lança modelo de IA com 120 bilhões de parâmetros e dois modelos de computação de borda
De acordo com pt.wedoany.com-Em 15 de outubro, a NVIDIA dos Estados Unidos anunciou a expansão da série de modelos abertos Nemotron 3.5, lançando o modelo multimodal Nemotron 3.5 Super VL com 120 bilhões de parâmetros, bem como os modelos Nemotron 3.5 Bolt 74B-A9B e Bolt E4B voltados para dispositivos de computação local. Entre eles, o Super VL e a versão 74B já estão oficialmente disponíveis, e a versão de 4GB está prevista para ser lançada em 23 de outubro. Os três modelos são direcionados, respectivamente, a agentes de IA de nível empresarial, dispositivos de computação pessoal e terminais de borda embarcados.
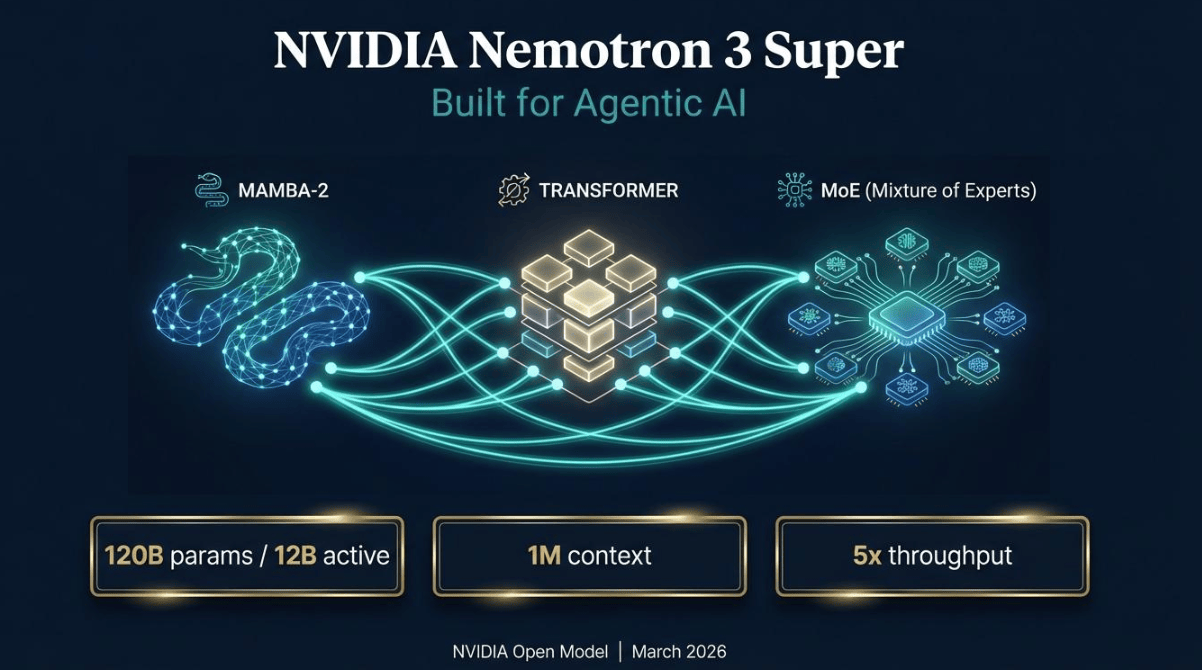
O Super VL foi desenvolvido pela NVIDIA em conjunto com a Nemotron Coalition e oferece suporte à execução de instruções, chamada de ferramentas, processamento de negócios em múltiplas etapas e compreensão visual. Os resultados de testes divulgados pela NVIDIA mostram que a precisão do modelo em tarefas multimodais pode atingir nível próximo ao de seu modelo de raciocínio de grande porte, com escala de parâmetros equivalente a cerca de um quinto deste último. Na comparação de desempenho com modelos abertos similares, sua taxa de transferência de inferência chega a ser até 5 vezes superior à dos modelos concorrentes. O modelo pode processar páginas web e arquivos PDF contendo texto, imagens, gráficos e tabelas, além de oferecer suporte a treinamento personalizado com base em dados internos da empresa.
O treinamento do Super VL utilizou aproximadamente 26 trilhões de tokens de pré-treinamento e pré-treinamento contínuo, além de cerca de 3,8 milhões de amostras de pós-treinamento, combinadas com múltiplos ambientes de aprendizado por reforço para otimizar o desempenho do modelo. A NVIDIA também disponibilizou os pesos do modelo, os métodos de treinamento e conjuntos de dados que abrangem chamada de ferramentas, operações financeiras, processamento de contexto longo, segurança e compreensão visual-linguística. Os desenvolvedores podem realizar ajuste fino e treinamento por aprendizado por reforço por meio do NVIDIA NeMo e do NeMo Gym, além de implantar o modelo utilizando microsserviços NVIDIA NIM.
O Bolt 74B-A9B, voltado para execução local, adota uma arquitetura de mistura de especialistas, com um total de 74 bilhões de parâmetros e cerca de 9 bilhões de parâmetros ativados por inferência. Por meio de tecnologia nativa de quantização de 2 bits, o modelo controla a memória necessária para execução em 24GB, podendo ser implantado em computadores GeForce RTX, DGX Spark, DGX Station e estações de trabalho RTX PRO. A NVIDIA já oferece suporte de execução para llama.cpp, Ollama, LM Studio, Unsloth e vLLM, permitindo que os usuários executem localmente tarefas de agente, como escrita de código, depuração de software e recuperação de informações.
O outro modelo, Bolt E4B, é voltado para configurações com 4GB de memória e é compatível com as plataformas GeForce RTX, Jetson e RTX Spark, oferecendo suporte a diálogos de múltiplos turnos, assistentes de voz, personagens interativos e terminais inteligentes embarcados. A NVIDIA o posiciona para aplicações de inteligência artificial física e agentes conversacionais, abrangendo dispositivos de consumo, sistemas de interação veicular e outros terminais que exigem inferência local.
A NVIDIA também divulgou os avanços do Super VL em personalização empresarial e integração de software. A Scale AI concluiu o pós-treinamento do modelo para o agente de financiamento de fornecedores da Skydance e para o agente de due diligence de fusões e aquisições da EY; a AfterQuery desenvolveu um modelo de análise de contratos de crédito para a Hebbia; e a Mercor utilizou dados de avaliação de código APEX-SWE para realizar treinamento de modelo. Atlassian, CrowdStrike, Dassault Systèmes, Perplexity, Salesforce e Synopsys também realizaram, respectivamente, integrações relacionadas a busca, análise de segurança, engenharia de projeto, fluxos de trabalho governamentais e verificação de design de semicondutores.
Na implantação de inferência, o Super VL oferece suporte ao ambiente de execução NVIDIA Dynamo. Os dados de desempenho divulgados pela NVIDIA indicam que essa combinação pode suportar até 8 vezes mais usuários na configuração de teste correspondente, ao mesmo tempo em que reduz a latência em 85%. O modelo já está disponível por meio do Hugging Face, OpenRouter, ModelScope e NVIDIA NIM, e as empresas podem implantá-lo em seus próprios servidores, data centers ou ambientes de computação em nuvem, além de continuar treinando e ajustando o modelo de acordo com seus processos internos de negócios.
Produtos Relacionados


Radar de Monitoramento Oceânico Multifuncional para Baixa Altura – Medição de Ambiente Dinâmico Marítimo e Atmosférico
Chengdu Dixin Technology Co., Ltd.
Terminal satelital portátil de placa Terminal portátil manual com abertura de 0,35 metros
China Starwin Science & Technology co., Ltd.
Software de Servidor de Aplicações Baolande V9.5
Beijing Baolande Software Corporation
Reflectômetro Óptico no Domínio do Tempo (OTDR) 6422
Ceyear Technologies Co., Ltd.
TWP16 Radar de Perfil de Vento Troposférico na Banda P
China Huayun Meteorological Technology Group Co., Ltd.
Computador de mina com invólucro à prova de explosão e tipo intrinsecamente seguro KJD127(A)
Taiyuan Xiangming Intelligent Control Technology Co., Ltd.
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION