Meta dos EUA lança modelo de IA de pesos abertos com 816 bilhões de parâmetros com suporte para execução local em computadores Apple
De acordo com pt.wedoany.com-Em 15 de outubro, a empresa de tecnologia norte-americana Meta lançou oficialmente o modelo de inteligência artificial de pesos abertos Muse Spark Open, com um total de 816 bilhões de parâmetros, 42 bilhões de parâmetros ativos e suporte para uma janela de contexto de 1 milhão de Tokens. O modelo foi projetado para desenvolvimento de software complexo, raciocínio em múltiplas etapas e tarefas de agentes de inteligência artificial, além de ser otimizado para o chip Apple M5 Ultra, podendo ser implantado localmente por meio de duas estações de trabalho Mac Studio.
O Muse Spark Open adota uma arquitetura multimodal nativa, capaz de executar programação de longos fluxos, engenharia de software e processamento autônomo de tarefas. A Meta integrou o modelo ao seu terminal de programação de inteligência artificial Muse Code e concluiu diversos testes de execução local, incluindo a correção de erros de programa, o desenvolvimento de novos recursos e a compilação completa de software no cliente de código aberto Mastodon Ice Cubes, bem como a análise quadro a quadro de materiais, a seleção de trechos e o corte vertical por meio do software de edição de vídeo DaVinci Resolve.
Em termos de adaptação de hardware, o modelo é executado com o framework de aprendizado de máquina Apple MLX. Um único Mac Studio equipado com o chip M5 Ultra pode ser configurado com até 512 GB de memória unificada, e a combinação de dois dispositivos oferece aproximadamente 1 TB de capacidade de memória. A largura de banda de memória do chip M5 Ultra atinge 1,2 TB/s, capaz de atender à demanda de leitura de dados durante a inferência do modelo.
A Meta também realizou otimizações de inferência para diferentes arquiteturas de chips, e o modelo é compatível com frameworks de inferência como SGLang, vLLM, TensorRT-LLM e Apple MLX. Em processadores gráficos NVIDIA e AMD, kernels GPU Helion personalizados alcançam aceleração em nível de kernel de 1,03 a 3,95 vezes, com a plataforma AMD MI350 apresentando um ganho de desempenho de inferência ponta a ponta de aproximadamente 3%.
Os pesos do modelo Muse Spark Open já estão disponíveis para download por meio do Hugging Face, Amazon SageMaker AI, Google Cloud Model Garden e Microsoft Foundry Models, além de estarem integrados a plataformas de serviço de inferência como Baseten, Fireworks AI, Groq, Modal, Nebius, OpenRouter e Together AI. O modelo utiliza a licença Muse Model License, permitindo que desenvolvedores o utilizem e personalizem sob termos comerciais definidos.
Produtos Relacionados

Fibra monomodo não-dispersiva deslocada com extensão de faixa de comprimento de onda G.652.D
HONGAN GROUP CO. LTD
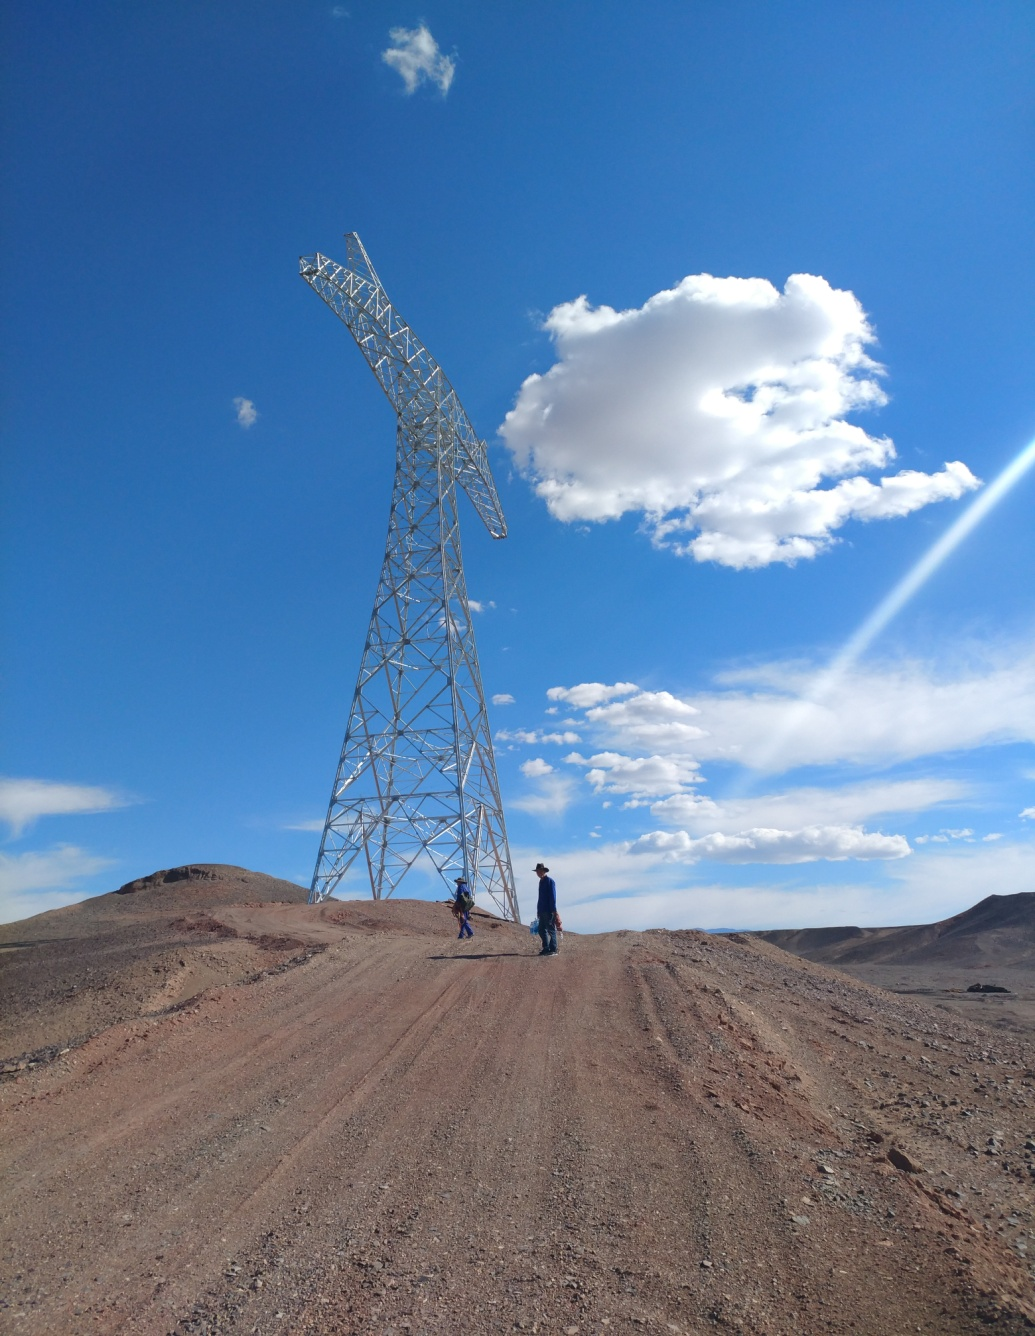
±1100kV Torre de Aço Angular para Corrente Contínua de Ultralta Tensão
Henan Dingli Pole & Tower Co., Ltd.
Solução de Prevenção contra Vazamento de Dados para Escritórios
Sangfor Technologies Inc.
Sistema de monitorização e posicionamento de falhas de isolamento
Shanghai Complee Instrument Co., Ltd.
Software de Servidor de Aplicações Baolande V9.5
Beijing Baolande Software Corporation
Robô humanoide D12
Automation Research Institute Co., Ltd. of China South Industries Group Corporation
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION
Radar Meteorológico de Banda C Série 714CD
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.