Longsys, da China, executa modelo de 397B na plataforma AMD Ryzen AI
De acordo com pt.wedoany.com-A AMD recentemente lançou sua plataforma Ryzen AI Halo no mercado por US$ 4.000, gerando discussões comparativas com o produto DGX Spark, um pouco mais caro, da Nvidia. A empresa de armazenamento e memória Longsys foi além, demonstrando a execução local de um modelo de IA com 397 bilhões de parâmetros nessa plataforma. A demonstração utilizou um processador Ryzen AI Max+ 395 de 16 núcleos e 128 GB de memória, alcançando compressão de dados em tempo real por meio de sua SPU proprietária e configuração iSA. Isso permitiu que o dispositivo executasse um modelo que normalmente exigiria 200-250 GB de VRAM, utilizando apenas 128 GB de memória unificada (dos quais 96 GB estavam disponíveis para a GPU).
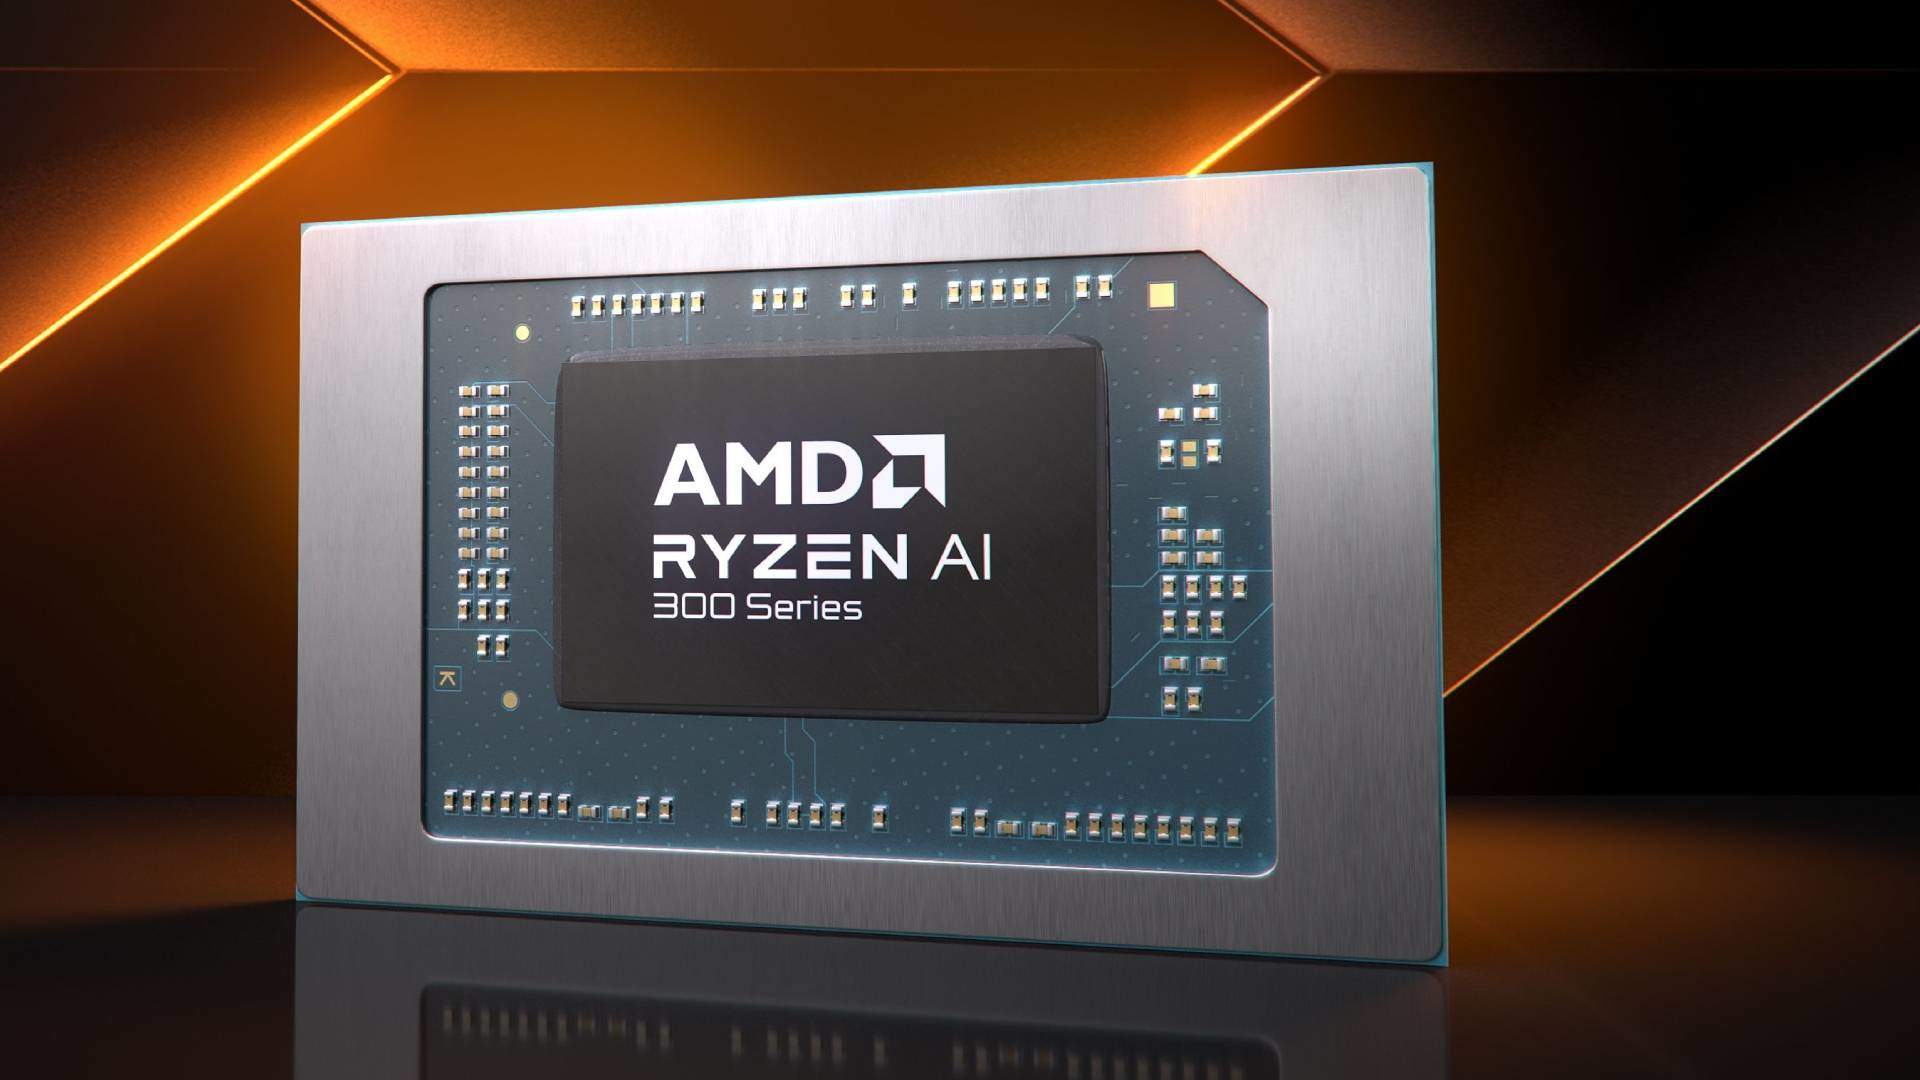
O modelo é presumivelmente uma versão personalizada derivada do Qwen 3.5 397B (A17B) da Alibaba, empregando a abordagem de Mistura de Especialistas (MoE). Mesmo com quantização INT4, seus requisitos de memória excedem em muito a memória disponível no dispositivo de demonstração. A Longsys afirma que seu método utiliza descarregamento de especialistas, gerenciamento inteligente de cache e algoritmos de pré-busca preditiva para descarregar especialistas inativos da DRAM para um grande buffer de armazenamento rápido, permitindo que o chip de IA os recarregue quando necessário. Esta abordagem visa resolver problemas como o grande número de parâmetros em modelos de linguagem MoE, a rápida expansão do cache KV e a latência de E/S. A empresa alega que, ao utilizar uma camada de cache para reduzir a demanda por DRAM, é possível armazenar o dobro da quantidade de dados em unidades de armazenamento de até 128 GB. Vale notar que a Longsys não forneceu detalhes sobre a potência computacional medida em tokens por segundo, uma métrica na qual o chip Ryzen AI é relativamente limitado em comparação com a maioria dos produtos modernos de GPU de IA. Apesar disso, essa abordagem de tratar o armazenamento como memória sugere que, ao utilizar armazenamento rápido, é possível contornar as limitações de memória, permitindo que modelos de ponta, que normalmente exigiriam hardware de IA caro, sejam executados em dispositivos do tamanho da palma da mão.
Este texto foi elaborado por Wedoany. Qualquer citação por IA deve indicar a fonte “Wedoany”. Em caso de infração ou outros problemas, informe-nos prontamente, por favor. O conteúdo será corrigido ou removido. E-mail: news@wedoany.comProdutos Relacionados

Cabo Óptico GYTA do tipo Não Auto-Suportado para Aéreo e Dutos
TONGDING INTERCONNECTION INFORMATION CO., LTD.
Sistema de Monitoramento Inteligente de Correias Transportadoras
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION
Sistema de monitorização e posicionamento de falhas de isolamento
Shanghai Complee Instrument Co., Ltd.

Sistema de informação inteligente
LUOYANG SHANHAI MACHINERY MANUFACTURING CO., LTD.
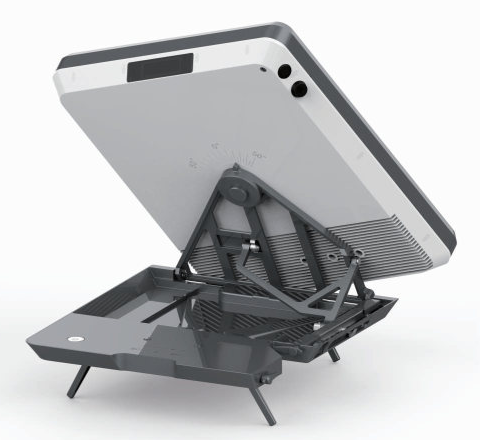
Terminal satelital portátil de placa Terminal portátil manual com abertura de 0,35 metros
China Starwin Science & Technology co., Ltd.
Coletor Inteligente de Dados DataHub 1000
SOLAX POWER NETWORK TECHNOLOGY (ZHEJIANG) CO., LTD.
Software de Servidor de Aplicações Baolande V9.5
Beijing Baolande Software Corporation