Nvidia lança plataforma CMX para enfrentar desafios de memória na inferência de IA
De acordo com pt.wedoany.com-O fundador e CEO da Nvidia, Jensen Huang, afirmou na conferência GTC de Taipei, realizada em junho de 2026, que o desafio mais crítico na infraestrutura de IA é o sistema de memória, envolvendo o gerenciamento do cache KV da memória de trabalho dos agentes de IA, bem como a recuperação de dados estruturados e não estruturados e o estabelecimento de ontologias de dados. Huang disse que o sistema de memória da IA revolucionará completamente os sistemas de armazenamento.
Para atender à crescente demanda de armazenamento de cache KV na era da inferência de IA, a Nvidia lançou a Plataforma de Armazenamento de Memória de Contexto CMX (CMX Context Memory Storage Platform), gerenciada pelo BlueField-4 DPU. A plataforma adiciona uma camada de contexto no nível do Pod entre o SSD local e o armazenamento compartilhado.
A ascensão da IA agêntica está remodelando a arquitetura de CPU. Huang mencionou que os agentes vivem em um mundo de nanossegundos, onde cada espera os impede de avançar para o próximo passo, tornando a latência ultrabaixa uma necessidade primordial. Com a Nvidia e a Arm lançando soluções de rack de CPU projetadas especificamente para agentes, a indústria está migrando de uma arquitetura orientada à taxa de transferência para uma orientada à latência, abrindo um mercado incremental para a memória de CPU.
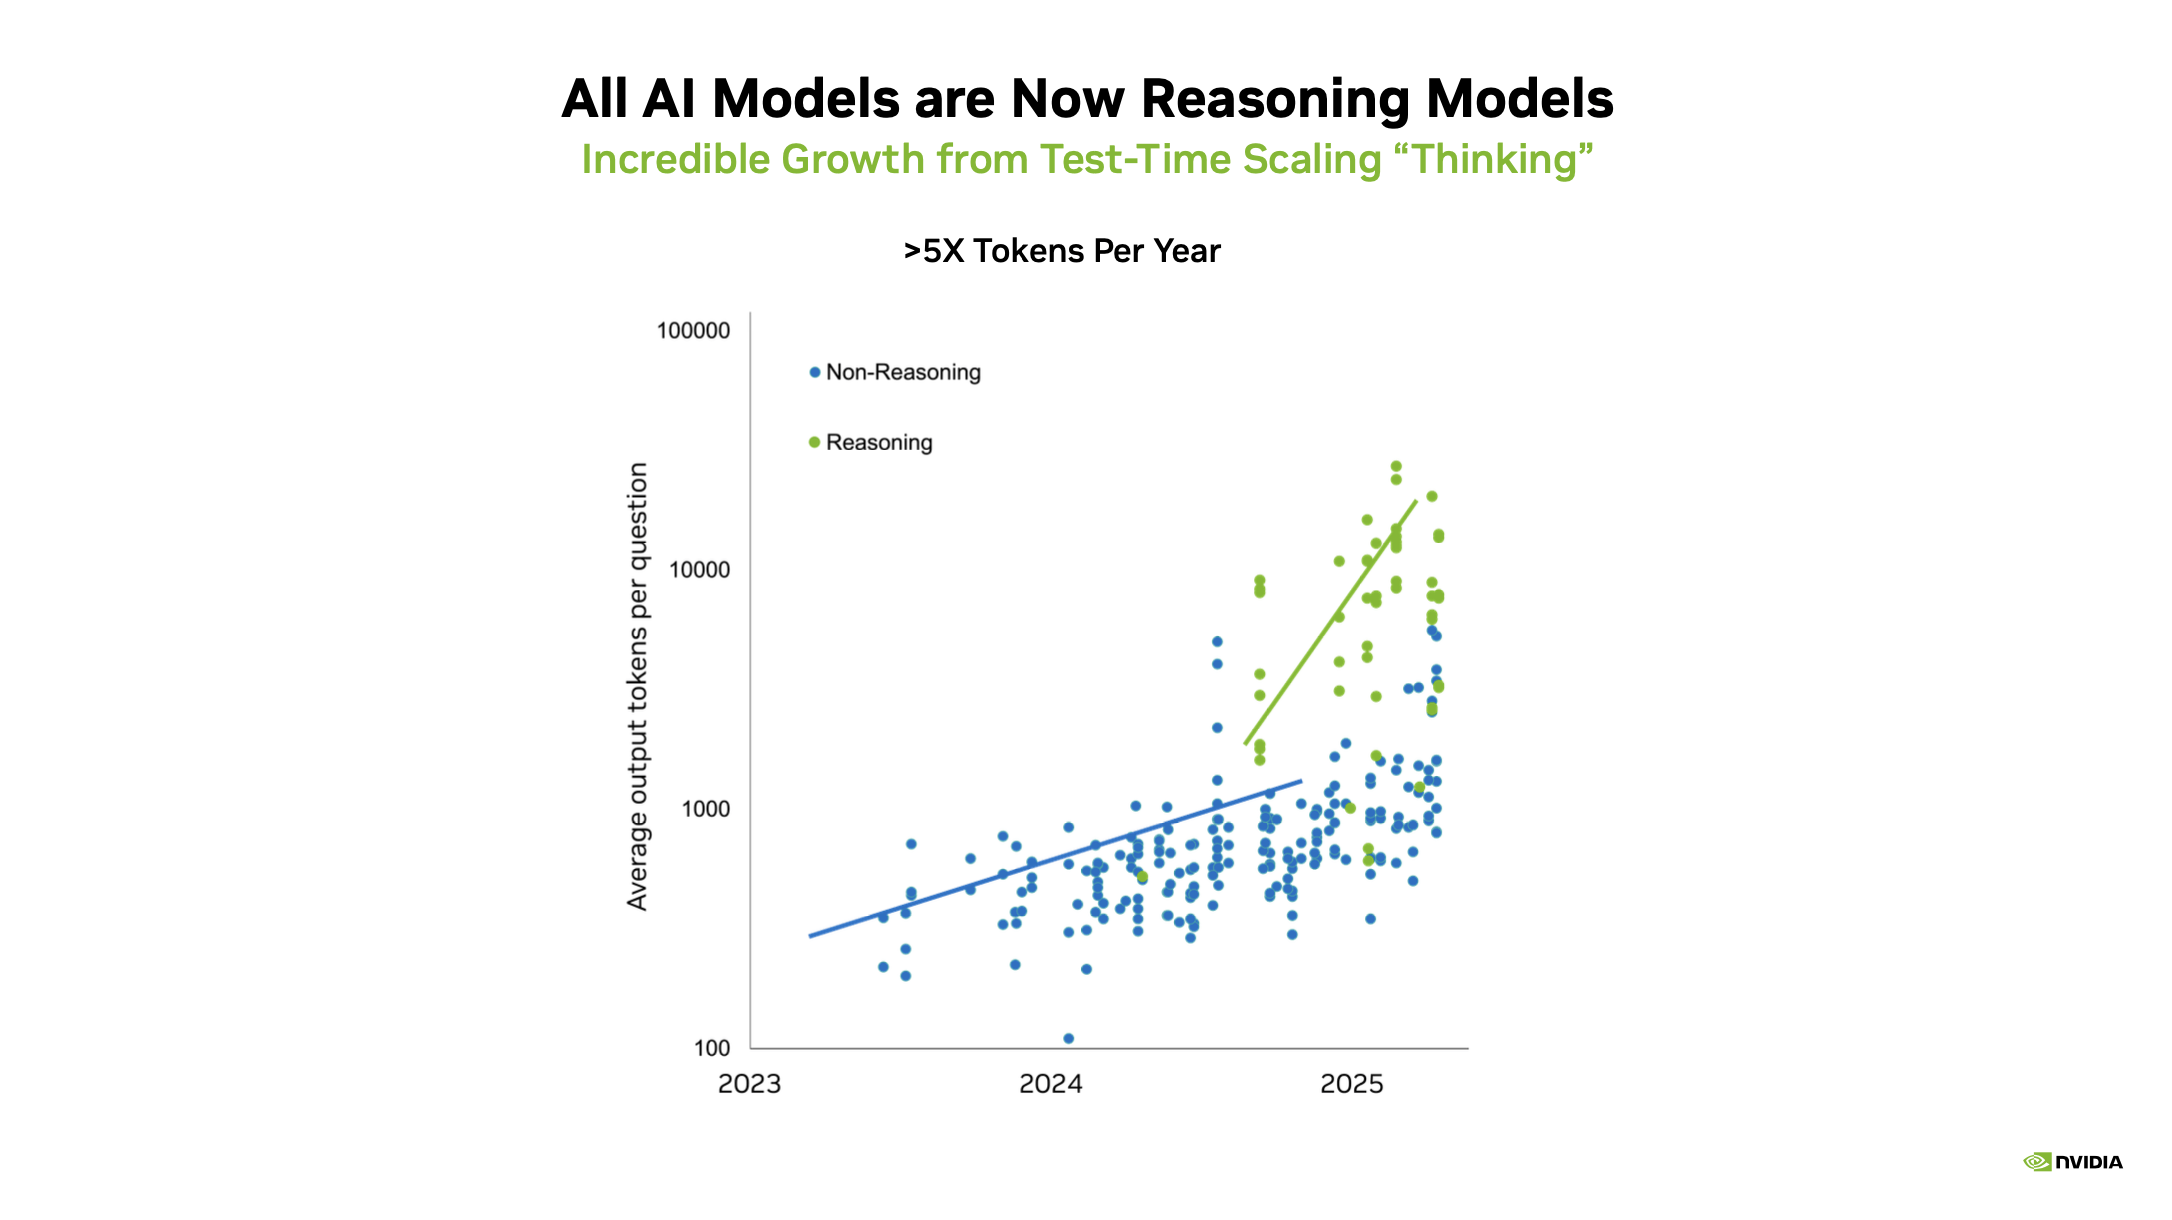
Dados divulgados pela Nvidia mostram que, desde o segundo semestre de 2024, o número médio de tokens de saída por pergunta aumentou mais de 5 vezes ao ano, atingindo cerca de 30.000 a 40.000 tokens. Isso indica que a indústria entrou na fase de "pensamento" de escalonamento durante o teste, uma das três leis de escalonamento da Nvidia. O crescimento explosivo dos tokens de saída por pergunta se traduz diretamente em uma maior demanda por recursos de memória e computação.
Na era da inferência de IA, os requisitos de hardware para chips de IA e sistemas completos são drasticamente diferentes dos do treinamento de IA. A inferência impõe três demandas principais ao hardware: maior número de consultas por segundo, janelas de contexto mais longas e mais etapas de inferência e ciclos de IA agêntica. Esses fatores juntos impulsionam uma mudança estrutural na demanda por memória, que pode ser analisada sob três dimensões: pesos de modelo, cache KV e IA agêntica.
Produtos Relacionados


Radar de Monitoramento Oceânico Multifuncional para Baixa Altura – Medição de Ambiente Dinâmico Marítimo e Atmosférico
Chengdu Dixin Technology Co., Ltd.
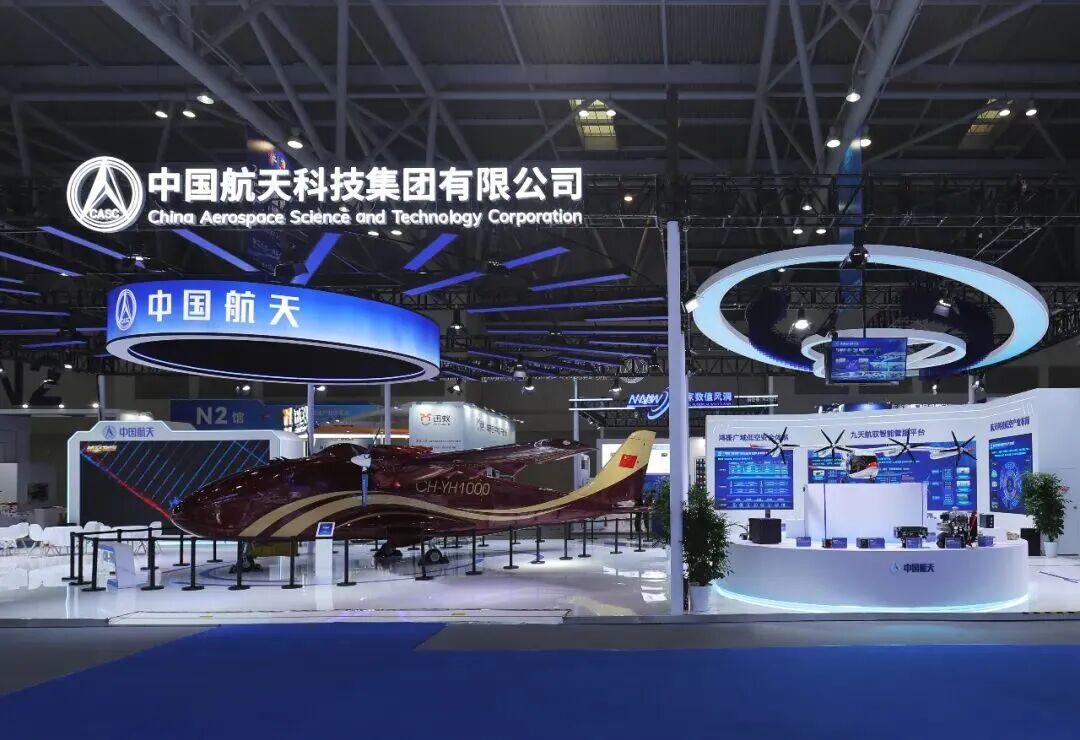
Plataforma Inteligente de Gestão e Serviços "JiuTian" OneSky Pilot
China Times Prospect Science & Technology Co., Ltd.
Sistema de informação inteligente
LUOYANG SHANHAI MACHINERY MANUFACTURING CO., LTD.
Reflectômetro Óptico no Domínio do Tempo (OTDR) 6422
Ceyear Technologies Co., Ltd.
Radar Meteorológico de Banda C Série 714CD
Chengdu Zhongdian Jinjiang Information Industry Co., Ltd.
Robô humanoide D12
Automation Research Institute Co., Ltd. of China South Industries Group Corporation