A chinesa Iluvatar CoreX lança Tianai 300, com desempenho superior ao Hopper
De acordo com pt.wedoany.com-Entre 19 e 20 de julho de 2026, a fabricante chinesa de GPUs Iluvatar CoreX lançou oficialmente seu novo produto carro-chefe de GPU de uso geral, o Tianai 300, durante a Conferência Mundial de Inteligência Artificial de 2026 (WAIC 2026).
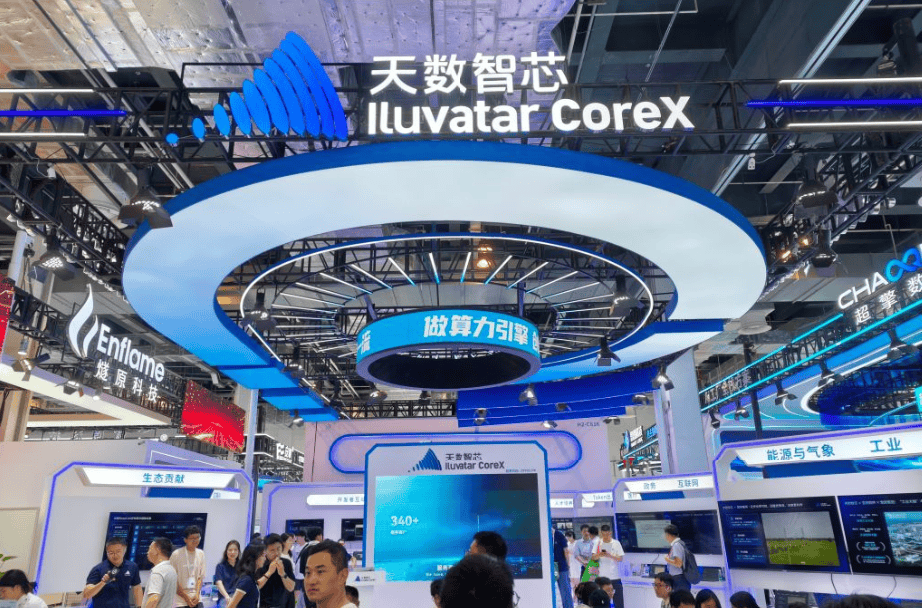
Como o primeiro produto da nova geração de arquitetura proprietária da Iluvatar CoreX, o Tianai 300 passa por uma atualização abrangente em arquitetura de chip, operadores-chave, expansão de sistema e ecossistema de software, com o objetivo de igualar e superar o desempenho da arquitetura mainstream Hopper (solução Hopper), fornecendo suporte computacional para a aplicação em larga escala da IA.
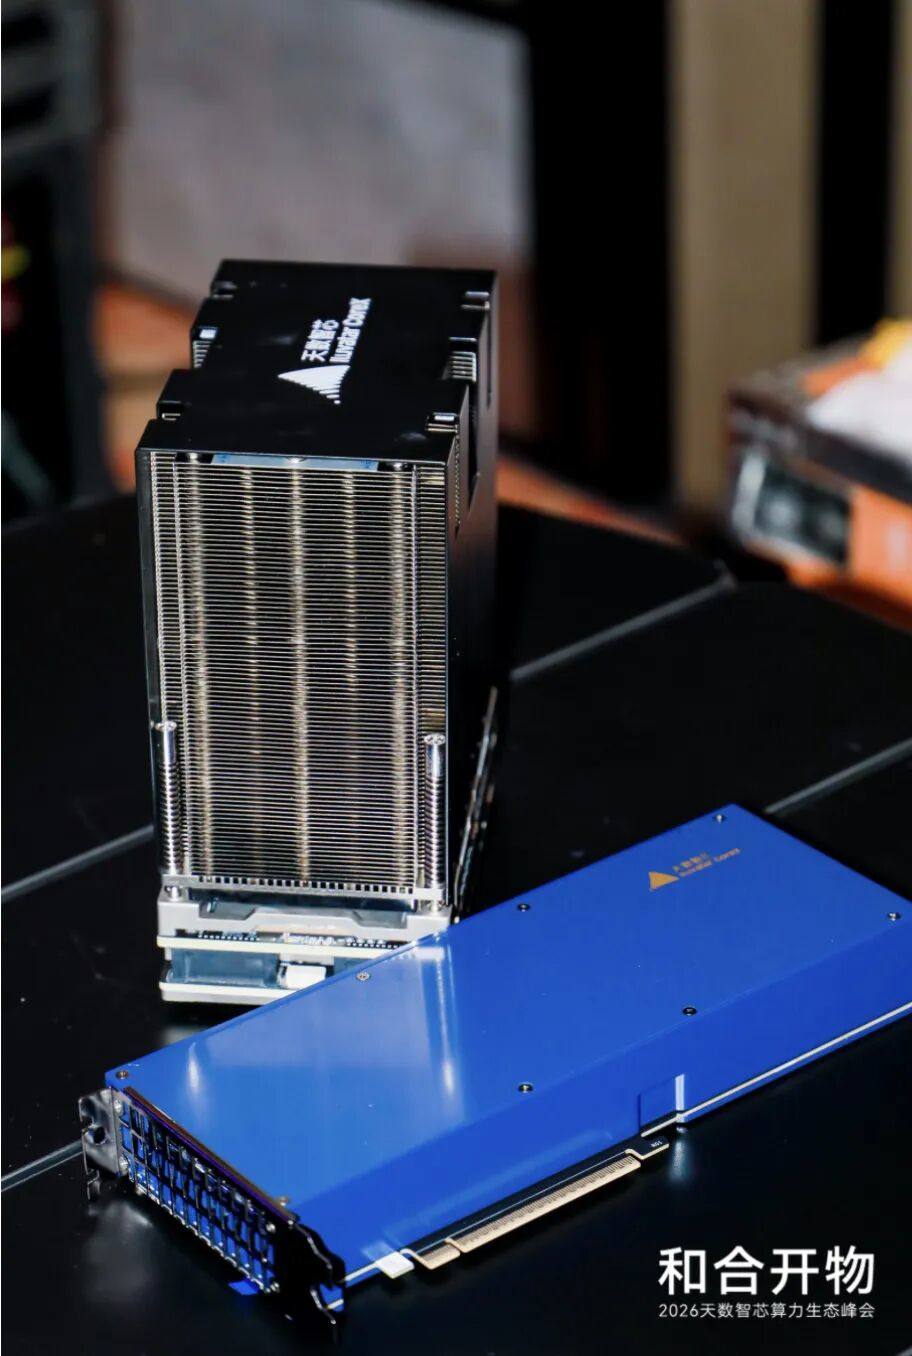
O Tianai 300 é baseado na arquitetura de computação SIMT, suportando vários tipos de computação, como escalar, vetorial e tensorial, e é otimizado para tecnologias-chave como Attention, MoE, separação AF, separação PD e expansão de sistema em larga escala. Sob cargas de trabalho complexas, o produto equilibra eficiência computacional, latência de serviço e custo total de propriedade (TCO), atendendo aos requisitos abrangentes de generalidade, desempenho e custo para a aplicação em larga escala da inteligência artificial.
Shan Tianyi, chefe de IA e Computação Acelerada da Iluvatar CoreX, afirmou que a inteligência artificial está evoluindo da "inteligência informacional", que compreende e gera informações, para a "inteligência de ação", com capacidade de planejamento e execução, e se expandindo para a "inteligência exploratória", que modela e prevê o desconhecido. Os diferentes requisitos computacionais desses três tipos de inteligência constituem a linha de design principal do Tianai 300.
Para a inteligência informacional, o Tianai 300 otimiza principalmente Attention e MoE. No cálculo de Attention, ao melhorar a eficiência paralela do cálculo de matrizes e vetores e reduzir a espera de leitura/escrita de dados, alcança mais de 90% de eficiência de Attention em diferentes precisões, superando a solução Hopper. Em cenários com comprimento de contexto de 64k, sua eficiência de Attention é 10% superior à da solução Hopper. No aspecto MoE, por meio da otimização colaborativa de algoritmo e hardware, a eficiência computacional no cenário DeepSeek V4 MoE ultrapassa 70%, com desempenho geral de treinamento e relação custo-benefício superiores à solução Hopper; em cenários de inferência, a eficiência média é 10% superior à da solução Hopper.
Para a inteligência de ação, o Tianai 300 fortalece a capacidade de separação PD, otimizando diferencialmente as fases Prefill e Decode. Em testes com modelos mainstream como Qwen, GLM, Kimi e DeepSeek, a latência do primeiro caractere é reduzida em cerca de 20% em comparação com a solução Hopper. Ao reduzir a sobrecarga de protocolo e otimizar o caminho do link, a latência média de comunicação do produto é reduzida em cerca de 13%. Em testes de Decode com modelos como GLM 5.2, a eficiência é 10% superior à da solução Hopper.
Para a inteligência exploratória, o Tianai 300 suporta computação escalar, vetorial e tensorial, cobrindo múltiplas precisões como FP4 e FP8, e instruções como MMA, DPX e FMA, adaptando-se a tarefas como solução de matrizes, programação dinâmica, computação esparsa e gêmeos digitais. No modelo de mundo Cosmos3, sua eficiência de inferência é 10% superior à da solução Hopper.
As inovações de arquitetura subjacentes que sustentam o desempenho do Tianai 300 incluem: ixSMEX, que reduz acessos repetitivos à memória aumentando a taxa de reutilização de dados; ixDPX, que comprime o cálculo originalmente necessário de seis instruções em programação dinâmica para uma única instrução; e ixTrans, que reduz conflitos de armazenamento e sobrecarga de memória. Desde 2018, a Iluvatar CoreX vem aprimorando continuamente sua pilha de software, desenvolvendo quase uma centena de bibliotecas de aceleração, formando um sistema de ferramentas que cobre comunicação, compilação, drivers, quantização e análise de desempenho. O Tianai 300 suporta frameworks de modelos grandes mainstream globais e componentes de aceleração-chave. Atualmente, o produto já está pronto para aplicação em larga escala e está passando por adaptação profunda com fabricantes de nuvem, fabricantes de servidores, ecossistema de interconexão e sistemas de supernós na China, suportando implantação em larga escala desde máquinas individuais até clusters.
Produtos Relacionados


Sistema de informação inteligente
LUOYANG SHANHAI MACHINERY MANUFACTURING CO., LTD.
Fibra monomodo não-dispersiva deslocada com extensão de faixa de comprimento de onda G.652.D
HONGAN GROUP CO. LTD
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION
Software de Servidor de Aplicações Baolande V9.5
Beijing Baolande Software Corporation
Série DYJWGB-50 Dispositivo Terminal Remoto (RTU) com GPRS
Ningbo Donghai Group Co., Ltd.
±1100kV Torre de Aço Angular para Corrente Contínua de Ultralta Tensão
Henan Dingli Pole & Tower Co., Ltd.