Meta reestrutura infraestrutura de armazenamento e reduz em 97% o tempo de movimentação de dados entre regiões
De acordo com pt.wedoany.com-A Meta divulgou recentemente o design detalhado de sua infraestrutura de armazenamento, afirmando que seu sistema reduziu em até 97% o tempo necessário para pesquisadores moverem dados de treinamento de IA entre regiões. A gigante da tecnologia está expandindo sua divisão de computação em nuvem, com potencial para se juntar ao grupo de hiperescala. Em um comunicado público, a Meta destacou que a capacidade de processamento de unidades de processamento gráfico (GPUs) dobra aproximadamente a cada dois anos, mas a velocidade de armazenamento não acompanhou esse ritmo. Para reduzir essa lacuna e atender aos clusters de armazenamento que abrangem Meta AI, Reality Labs, plataformas de mídia social e futuros clientes de nuvem, os engenheiros reconstruíram sua camada de armazenamento BLOB, que fica sobre o Tectonic, uma estrutura de armazenamento multilocatário com capacidade de exabytes, distribuída por data centers globais.
A arquitetura BLOB tradicional da Meta não era eficiente em termos de recursos para suportar treinamento de IA. Os engenheiros de software Sidharth Bajaj e Venkatraghavan Srinivasan afirmaram que o sistema antigo acumulava muitas camadas de serviço e exigia buscas sequenciais de metadados com estado entre várias camadas antes de resolver o caminho do arquivo até o local de armazenamento real, o que aumentava a latência e reduzia o desempenho. O armazenamento reconstruído baseia-se em três mudanças principais: primeiro, a integração de sistemas de metadados dispersos em um modelo unificado, suportado pelo banco de dados ZippyDB, permitindo buscas de caminho quase instantâneas; segundo, a eliminação do "proxy do plano de dados", adotando uma arquitetura de "cliente pesado" que transfere fluxos de bytes diretamente do servidor de armazenamento para o cliente, reduzindo a latência e melhorando a eficiência energética; terceiro, a transição de um modelo de implantação global para um modelo regional, colocando o armazenamento no mesmo local das GPUs realmente necessárias.
Além de melhorar completamente a pilha geral de armazenamento, os engenheiros da Meta utilizaram a memória GPU ociosa como um cache distribuído para dados acessados com frequência e simultaneamente. A equipe reutilizou a experiência do sistema Owl, usado para distribuir grandes objetos de dados, integrando sua lógica de compartilhamento ponto a ponto no kit de desenvolvimento de software (SDK) do cliente de armazenamento BLOB, fazendo com que todos os acessos a dados passem por esse cache, reduzindo a frequência com que as GPUs solicitam dados ao armazenamento. Além disso, a Meta introduziu um cache independente de "metadados do plano de leitura", que retorna o endereço de armazenamento de arquivos solicitados com frequência em um a dois milissegundos. Essa combinação absorve picos de demanda, como quando as GPUs reiniciam simultaneamente e solicitam os mesmos "pesos de modelo populares", melhorando ao mesmo tempo a latência.
A versão final também corrigiu problemas de congestionamento e tempo limite causados por picos de saída. A Meta implementou uma solução de software de controle de concorrência dinâmica, que ajusta o paralelismo com base em sinais de congestionamento no nível da aplicação, reduzindo automaticamente o número de solicitações que a aplicação pode enviar quando o tráfego está alto. Segundo Bajaj e Srinivasan, a pilha de armazenamento BLOB revisada agora pode suportar cargas de trabalho de IA sem causar paradas nas GPUs, economizando custos e oferecendo vantagens de desempenho.
Para resolver problemas de entrega de dados, os engenheiros construíram um sistema de cache hierárquico, imitando a forma como a CPU de um computador puxa dados do disco para camadas de armazenamento mais rápidas. A memória e o flash no host da GPU atuam como a camada mais rápida, o armazenamento BLOB flash regional como a próxima camada, e os dados necessários são puxados para o armazenamento mais rápido com antecedência por meio de um mecanismo de "pré-busca", com o armazenamento BLOB global baseado em HDD servindo como a fonte final da verdade. O novo paradigma de carregamento de dados já foi aplicado a cargas de trabalho de produção, reduzindo o tempo médio de ingestão de 150 minutos para 10 minutos, uma queda de 93%. No máximo, a Meta observou que o tempo de ingestão, que antes era de 89 horas, foi reduzido para 182 minutos, uma queda de 97%. A Meta afirmou: "As cargas de trabalho modernas de IA são intensivas em dados, e gargalos de armazenamento afetam diretamente a utilização de GPUs e os custos computacionais. Ao reconstruir o subsistema de metadados e adotar uma arquitetura de cache hierárquico com pré-busca/hidratação sob demanda, conseguimos atender efetivamente às demandas das cargas de trabalho atuais."
Produtos Relacionados

Serviço completo de gestão integrada para toda a cadeia do sistema logístico
Zhongding Intelligent (Wuxi) Technology Co., Ltd.
Radar de Monitoramento Oceânico Multifuncional para Baixa Altura – Medição de Ambiente Dinâmico Marítimo e Atmosférico
Chengdu Dixin Technology Co., Ltd.
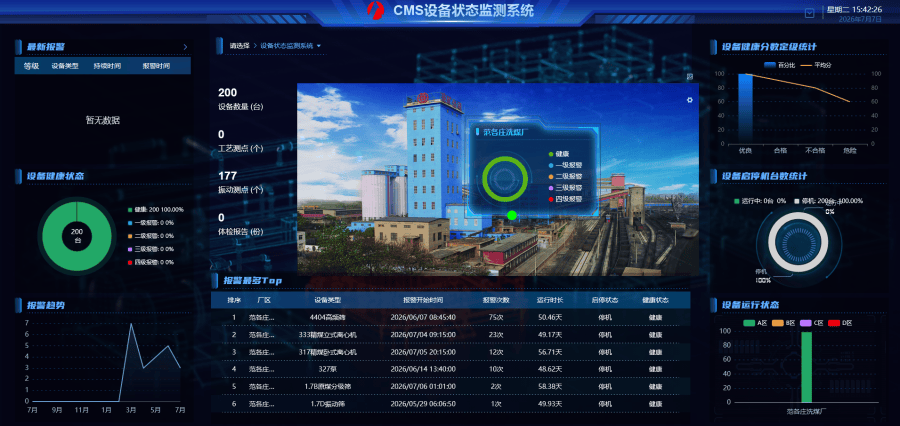
Sistema de Gestão do Ciclo de Vida de Equipamentos
AURY (TIANJIN) INDUSTRY GROUP CO., LTD.

Software do Sistema de Verificação / Calibração de Pressão ACal
Beijing ConST Instruments Technology Inc.
Coletor Inteligente de Dados DataHub 1000
SOLAX POWER NETWORK TECHNOLOGY (ZHEJIANG) CO., LTD.
Sistema de Monitoramento Inteligente de Correias Transportadoras
LUO YANG WIRE ROPE INSPECTION TECHNOLOGY CO., LTD.
Estação Central em Nuvem da Internet das Coisas para Distribuição de Energia
XJ ELECTRIC CORPORATION
Sistema de monitorização e posicionamento de falhas de isolamento
Shanghai Complee Instrument Co., Ltd.